Google оновила свій рейтинг Android Bench, який показує, наскільки добре AI-моделі справляються з допомогою при Android-розробці. Результат власного Gemini 4 Argon виявився значно гіршим, ніж у найсвіжіших моделей Claude та GPT.
Android Bench з’явився на початку цього року як інструмент для Android-розробників: зручний спосіб дізнатися, яка AI-модель краще підходить для написання коду під Android. Тест враховує аспекти, специфічні саме для Android-розробки та її кращих практик. З часом Google додала до бенчмарку ще один критерій – середню вартість використання моделі, щоб розробники могли ухвалювати зважені рішення.
В оновленні від 26 жовтня Google додала інформацію про рівень reasoning для кожної моделі, а також результати OpenAI GPT-6 Sol, GPT-6.1 Sol, Claude Sonnet 5, Claude Sonnet 5.5 і власного Gemini 4 Argon.
Хто очолює рейтинг
Першу позицію наразі займає Claude Sonnet 5.5 з показником проходження тестів 40% і рівнем виконання завдань 80,9%. Друге місце посів Claude Opus 5.5, доданий до рейтингу на початку жовтня.
Найцікавішим новачком виглядає OpenAI GPT-6.1 Sol: pass rate – 29,3%, completion rate – 82,8%, а вартість – лише $99,50. Для порівняння, Claude на першому місці обходиться в $1574,90.
Gemini 4 Argon – розчарування рейтингу
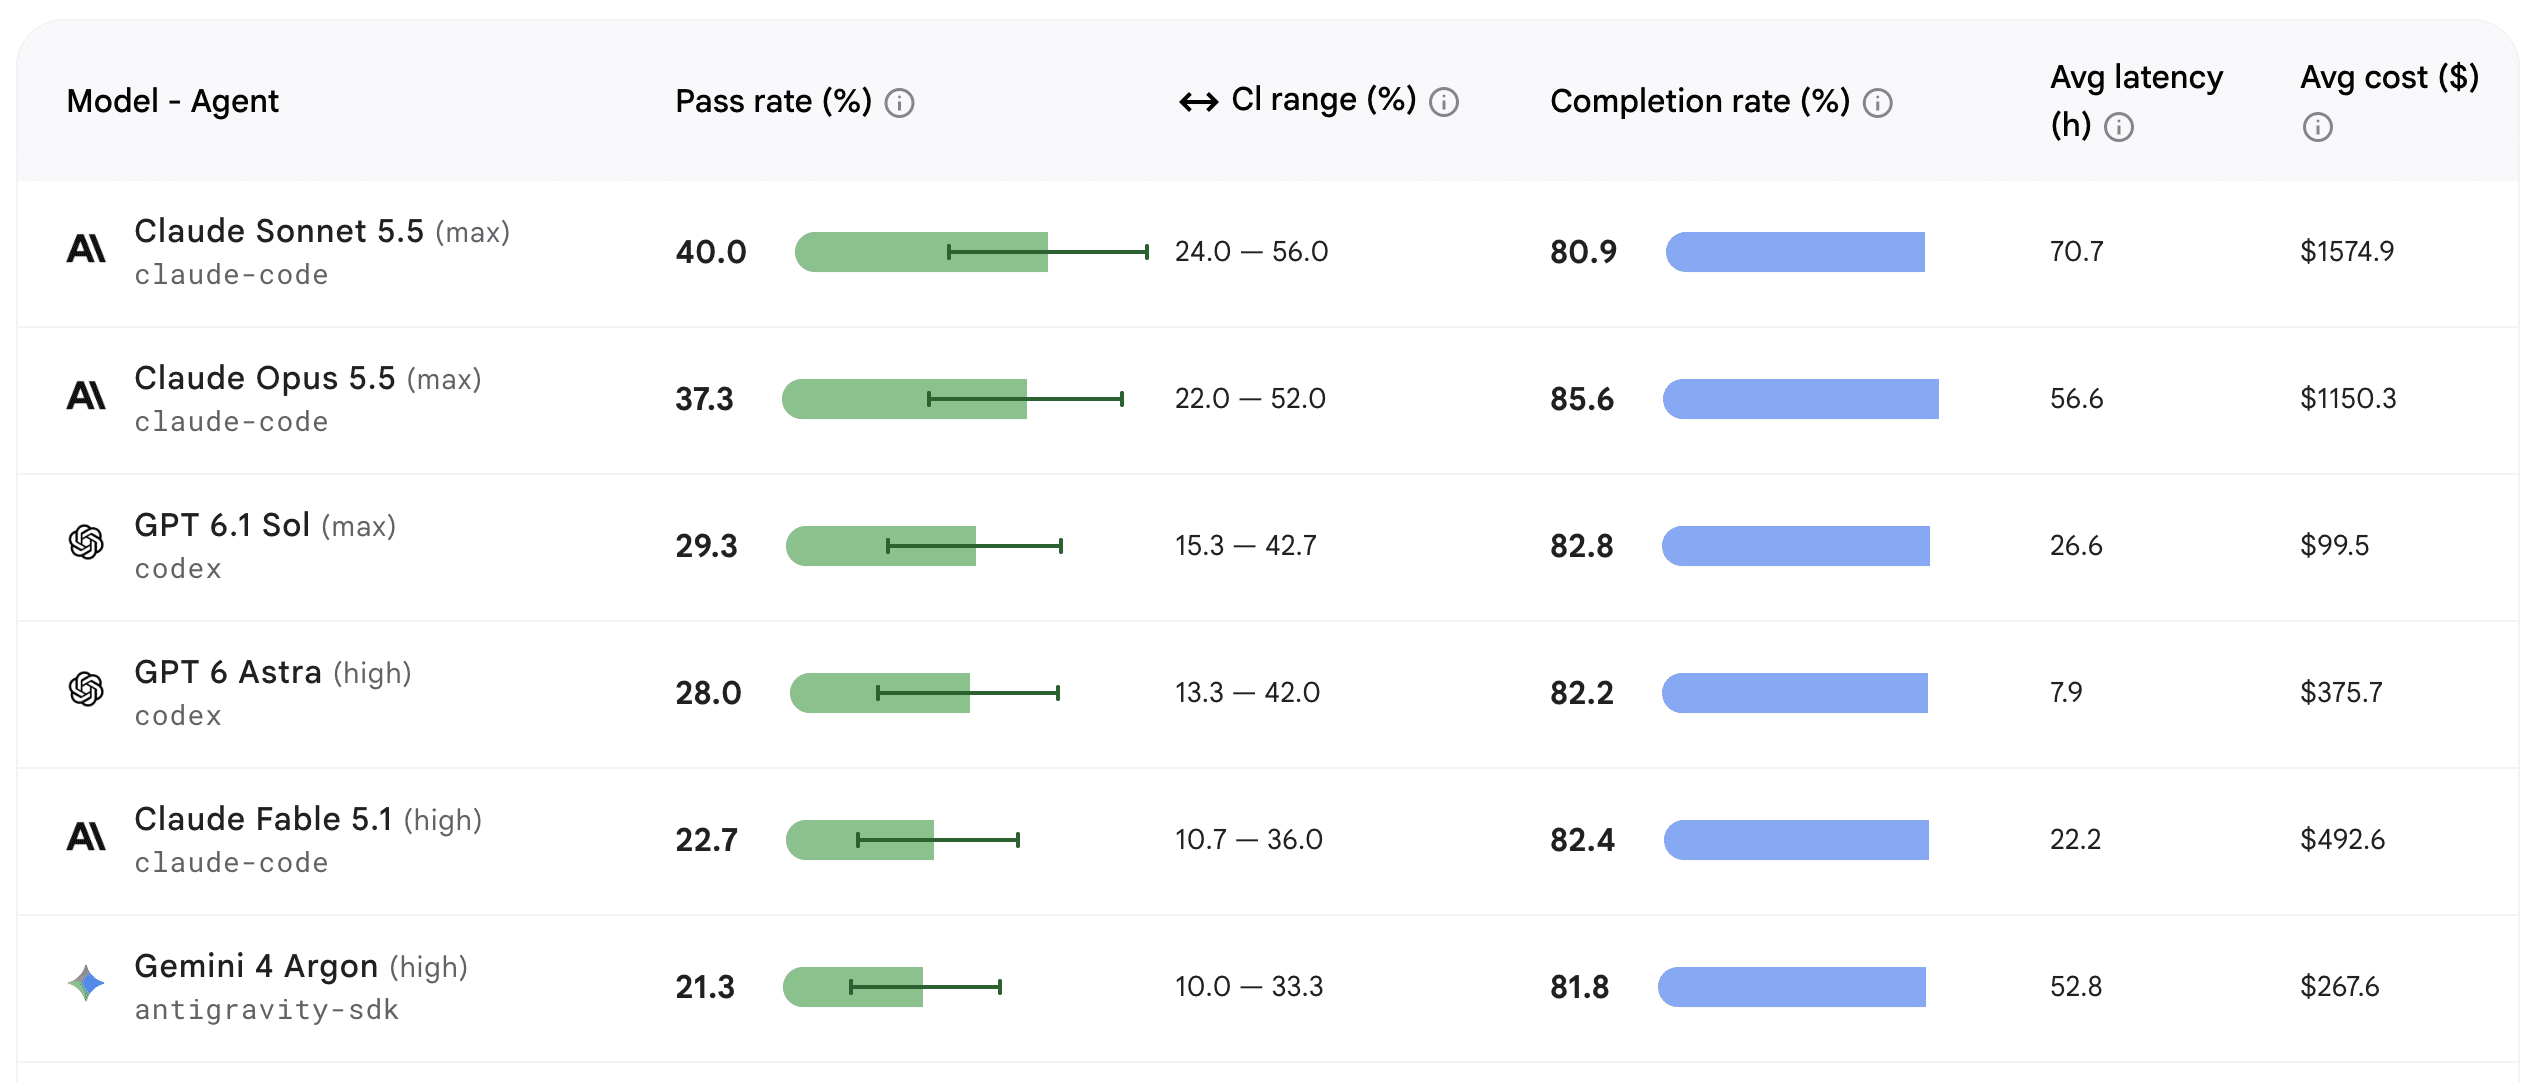
Власна модель Google – Gemini 4 Argon – дебютувала невиразно: п’яте місце і відставання від інших топових моделей. Її результати – 21,3% pass rate, 81,8% completion rate і середня вартість $267,70 – виявилися нижчими навіть за Claude Fable 5.1.
Невдовзі після анонсу Gemini 4 Argon у пресі з’явилися повідомлення з посиланням на внутрішні джерела Google: модель нібито «важко справляється з певними завданнями у сфері програмування». Google, однак, відстоює її можливості.
Джерело – 9to5Google